
lyonzin/knowledge-rag

lyonzin/knowledge-rag

от lyonzin
Ищет по PDF, markdown, коду и блокнотам офлайн. 1800+ файлов индексирует за 3 минуты, гибридный поиск с реранкингом. Без API-ключей, данные не покидают машину.

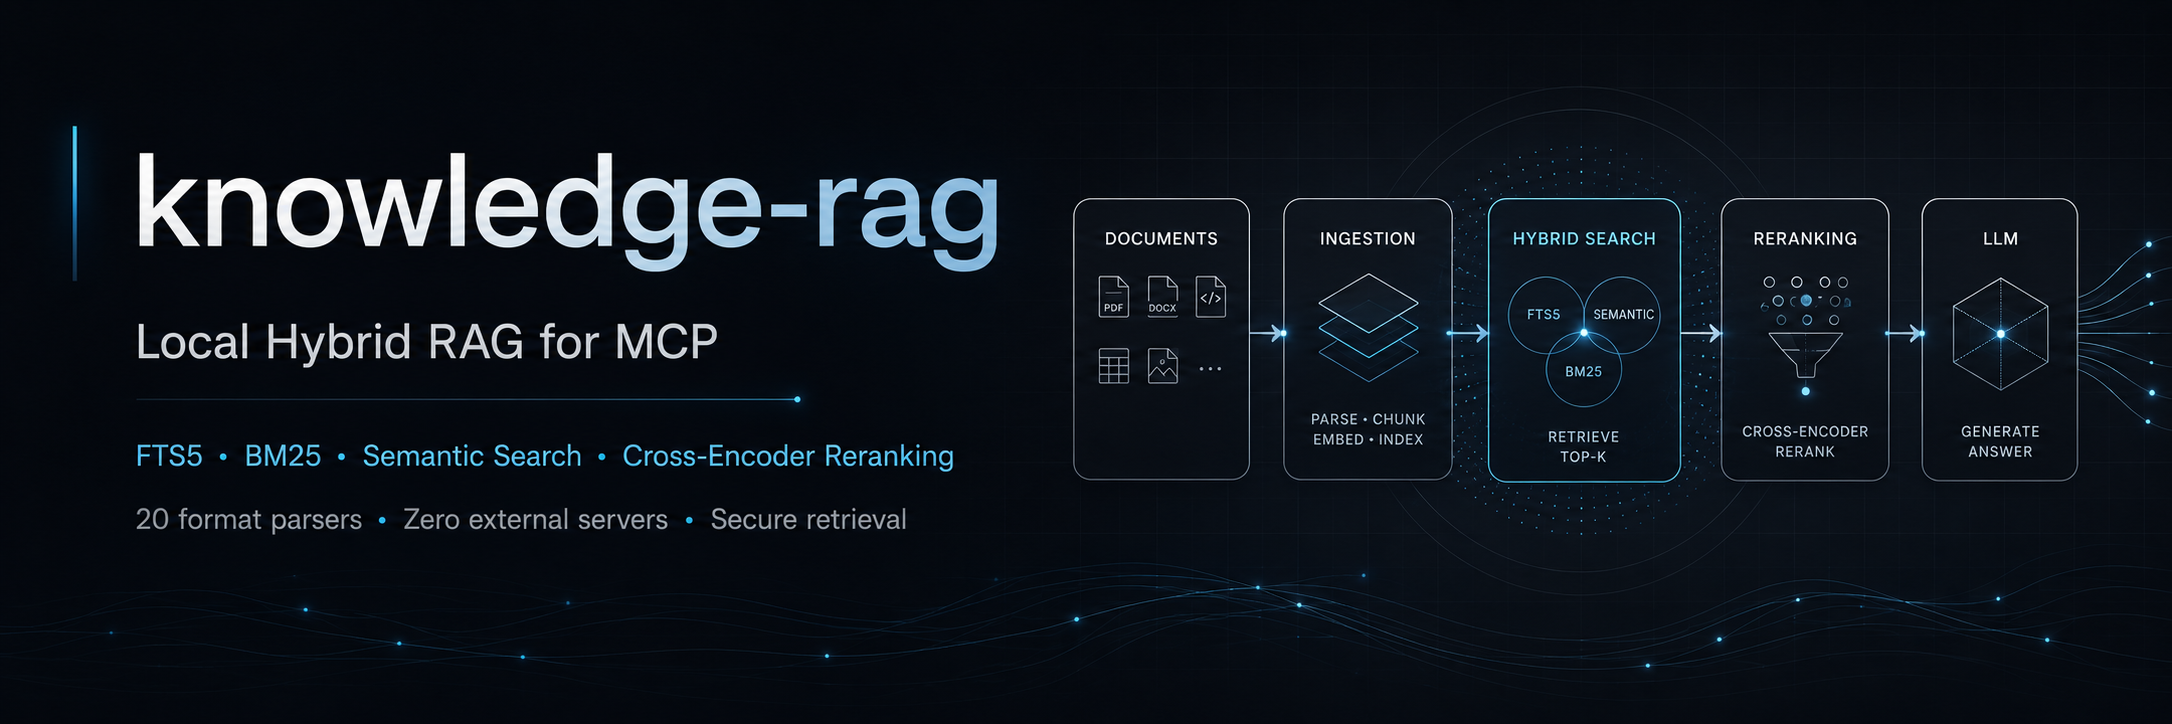
knowledge-rag — Local Hybrid RAG for MCP

knowledge-rag

PyPI NPM PyPI Downloads Python License Platform GPU CI CodeQL Quality Gate Glama Score OpenSSF Best Practices

The MCP-first local RAG server for Claude Code, Cursor, and every AI agent.

Hybrid search · Cross-encoder reranking · 35 file formats · 100% local · Zero cloud · Enterprise-grade plumbing built-in.

pip install knowledge-rag   →   restart Claude Code   →   search_knowledge("your query")

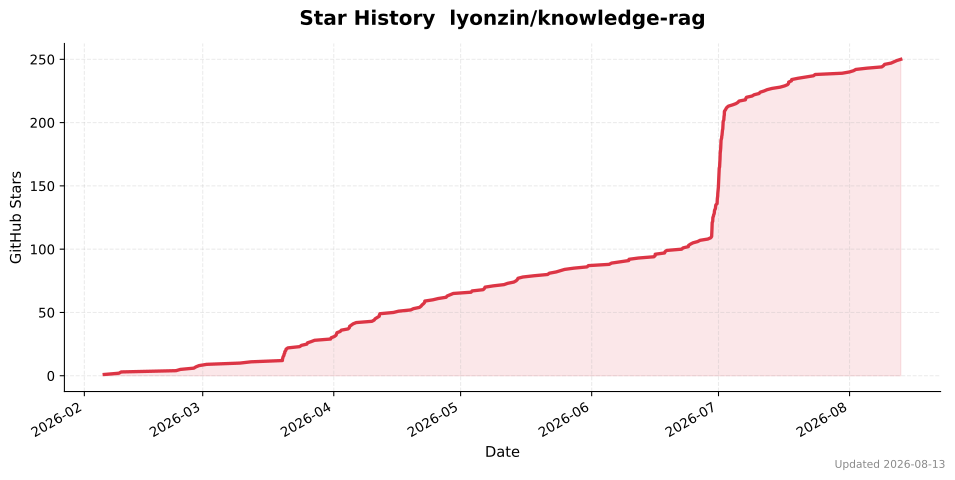
⭐ Star History

knowledge-rag star history chart — GitHub star growth over time

Chart updated daily by GitHub Action


🎯 Why knowledge-rag

Most RAG frameworks fall into one of three traps: (1) they require you to ship your data to a cloud API, (2) they hand you 300 building blocks and 0 opinionated defaults, or (3) they bundle RAG as a 5% feature of a much bigger platform you didn't ask for.

knowledge-rag is an MCP-native local RAG server for clients such as Claude Code, Cursor, Windsurf, VS Code, Cline, Gemini CLI and Zed. It includes optional bearer authentication, Prometheus metrics, rate limiting, health probes, structured JSON logging and staging-based rebuilds. Configure the transport and access controls for the intended deployment.

Часто задаваемые вопросы

Инструменты были проиндексированы:
add_document

Добавляет новый документ в базу знаний из текстового содержимого. Изменяет состояние: записывает файл на диск и сразу индексирует его. Аутентификация не требуется. Аргументы: content: Полное текстовое содержимое документа (поддерживается Markdown) filepath: Относительный путь внутри каталога документов (например, "security/new-technique.md"). Подкаталог должен соответствовать категории. category: Категория документа, одна из: security, ctf, logscale, development, general, redteam, blueteam (по умолчанию: general) Возвращает: JSON-строку с результатами индексирования (filepath, chunks created, status). Использование: Используйте для добавления новых документов из текстового содержимого. Если источник - веб-страница, используйте add_from_url(). Для замены содержимого существующего файла используйте update_document(). Документ становится доступным для поиска сразу после этого вызова, ручная переиндексация не требуется.

Параметры
  • categorystring
  • contentstringобязательный
  • filepathstringобязательный
add_from_url

Извлекает содержимое по URL, преобразует в Markdown и добавляет в базу знаний. Mutating: выполняет исходящий HTTP-запрос (требуется доступ в интернет), удаляет HTML, преобразует в Markdown, сохраняет на диск и сразу индексирует. Args: url: Полный URL для загрузки (обязателен https). Страница должна быть публично доступной. category: Категория документа - одна из: security, ctf, logscale, development, general, redteam, blueteam (по умолчанию: general). title: Необязательный заголовок документа. Если не указан, автоматически определяется из тега <title> страницы. Returns: JSON-строка с результатами индексации (обнаруженный заголовок, путь к файлу, количество созданных чанков, статус). Usage: Используйте для загрузки веб-контента (райтапы, записи в блогах, страницы документации) напрямую по URL. Если у вас уже есть текстовое содержимое, используйте add_document(). Документ становится доступным для поиска сразу после вызова: ручная переиндексация не нужна.

Параметры
  • categorystring
  • titlestring
  • urlstringобязательный
evaluate_retrieval

Оценивает качество поиска, проверяя, извлекает ли search_knowledge() ожидаемые документы. Только чтение. Внутри выполняет несколько поисковых запросов. На индекс не влияет. Параметры: test_cases: JSON-строка с массивом тестовых случаев. Каждый элемент должен содержать "query" (поисковая строка) и "expected_filepath" (путь к документу, который должен попасть в первые 5 результатов). Пример: [{"query": "suid exploit", "expected_filepath": "security/suid.md"}] Возвращает: JSON-строку с MRR@5 (Mean Reciprocal Rank), Recall@5 и разбивкой по попаданиям и промахам для каждого запроса. MRR@5 выше 0.7 указывает на хорошее качество поиска. Применение: Используйте для проверки качества поиска после массовой загрузки документов или после настройки hybrid_alpha. Для проверки состояния системы вместо этого используйте get_index_stats(). Для непосредственного извлечения документов используйте search_knowledge(), а этот инструмент только измеряет качество.

Параметры
  • test_casesstringобязательный
get_document

Получает полное содержимое конкретного документа по пути к файлу. Только чтение. Побочных эффектов нет. Аргументы: filepath: относительный путь к документу в каталоге документов (например, "security/technique.md"). Должен быть индексированным файлом: используйте list_documents(), чтобы просмотреть доступные пути, или search_knowledge(), чтобы сначала найти путь к файлу по теме. Возвращает: JSON-строку с полным содержимым документа и метаданными (filepath, category, size). Применение: используйте, когда нужен полный текст известного файла: search_knowledge() возвращает фрагменты, а не полные документы. Сначала используйте search_knowledge(), чтобы найти путь к файлу, если он неизвестен. Используйте list_documents(), чтобы просмотреть все доступные файлы по категориям.

Параметры
  • filepathstringобязательный
get_index_stats

Получает статистику и показатели работоспособности для индекса базы знаний. Только чтение. Без побочных эффектов. Возвращает: JSON-строку с системными метриками: общее количество документов, количество чанков, название модели эмбеддингов, статус BM25, долю попаданий в кэш запросов и статус наблюдателя за файлами. Использование: используйте для проверки работоспособности системы: убедитесь, что модель эмбеддингов загружена, проверьте наполненность индекса или следите за эффективностью кэша. Чтобы получить количество документов по категориям, используйте вместо этого list_categories(). Чтобы измерить реальное качество поиска, используйте evaluate_retrieval() с тестовыми запросами.

Параметры

Без параметров.

get_reindex_status

Получает текущий статус фоновой операции переиндексации. Легковесная: не вычисляет полную статистику индекса. Используйте её для опроса прогресса после вызова reindex_documents(). Возвращает: JSON-строку со статусом переиндексации. Когда операция активна: имя операции, прогресс (обработано/всего), процент выполнения, счётчики проиндексировано/пропущено/ошибок и время начала. Когда операция неактивна: active=false, а также last_result или last_error из последней завершенной переиндексации. Использование: вызывайте её повторно после reindex_documents(), чтобы отслеживать прогресс. Когда reindex.active становится false, операция завершена. Используйте get_index_stats(), чтобы получить полные метрики состояния индекса.

Параметры

Без параметров.

list_categories

Перечисляет все категории документов с количеством документов в каждой. Только чтение. Без побочных эффектов. Отражает текущее состояние индекса. Возвращает: JSON-строку с названиями категорий, количеством документов по каждой категории и общим количеством документов. Использование: используйте перед фильтрацией search_knowledge() или list_documents() по категории, чтобы увидеть, какие категории существуют и сколько документов содержит каждая. Вместо этого используйте get_index_stats() для более широких метрик состояния системы (название модели, частота попаданий в кэш, статус BM25).

Параметры

Без параметров.

list_documents

Перечисляет все индексированные документы, опционально отфильтрованные по категории. Только чтение. Без побочных эффектов. Аргументы: category: необязательный фильтр по категории. Нужно указать допустимое имя категории. Вызовите list_categories(), чтобы увидеть доступные варианты (например, security, ctf, logscale, development, general, redteam, blueteam). Возвращает: JSON-строку со списком путей к документам, категорий и метаданных для каждого индексированного файла. Использование: используйте, чтобы просмотреть содержимое индекса или убедиться, что конкретный файл проиндексирован. Сначала вызовите list_categories(), чтобы увидеть допустимые имена категорий. Используйте search_knowledge(), когда нужно найти документы по теме, а не просматривать полный список. Используйте get_document(), чтобы прочитать конкретный файл, как только получите его путь.

Параметры
  • categorystring
reindex_documents

Индексирует или переиндексирует все документы в базе знаний (выполняется в фоне). force — умная переиндексация (обнаруживает изменённые файлы + перестраивает BM25). Используйте после изменений в файловой системе вне add_document/update_document. full_rebuild — полная перестройка (удаляет + повторно встраивает). Используйте только после изменения модели встраивания или повреждения индекса. Взаимоисключающе с resume. resume — возобновляет прерванную умную переиндексацию из data/reindex_checkpoint.json. Бесшумно переключается на свежий умный запуск, если контрольная точка отсутствует, повреждена или устарела (v4.8.0, этап 4). Возвращает JSON-обёртку. Опрашивайте get_reindex_status(), пока reindex.active не станет false. Инструменты добавления/обновления/URL уже автоиндексируют — используйте эти флаги только для сценариев восстановления/перестройки, описанных выше.

Параметры
  • forceboolean
  • full_rebuildboolean
  • resumeboolean
remove_document

Удаляет документ из индекса базы знаний. Мутирующая операция — удаляет записи индекса. Если delete_file=True, также навсегда удаляет файл с диска (необратимо, отменить невозможно). Аргументы: filepath: Путь к файлу документа. Должен быть проиндексированным документом — используйте list_documents(), чтобы найти доступные пути. delete_file: Если True, навсегда удаляет файл с диска в дополнение к удалению из индекса (по умолчанию: False). Возвращает: JSON-строку с результатами удаления (filepath, status). Использование: Используйте для удаления документа из индекса, сохраняя файл на диске (по умолчанию). Устанавливайте delete_file=True только для полного удаления. Используйте update_document() для замены содержимого вместо удаления. Используйте reindex_documents(force=True), если вы удалили файл вручную за пределами этого инструмента.

Параметры
  • delete_fileboolean
  • filepathstringобязательный
search_knowledge

Гибридный поиск, объединяющий семантический поиск + ключевой поиск BM25 с кросс-энкодерным переранжированием. Только чтение. Без побочных эффектов. Аргументы: query: Текст поискового запроса (рекомендуется 1–3 ключевых слова; фразовые запросы тоже работают) max_results: Максимальное количество результатов (по умолчанию: 5, макс.: 20) category: Необязательный фильтр категории — одно из: security, ctf, logscale, development, general, redteam, blueteam. Сначала вызовите list_categories(), чтобы увидеть доступные категории и количество. hybrid_alpha: Баланс между семантическим и ключевым поиском. 0.0 = только ключевой (лучше всего для точных технических терминов вроде CVE ID или названий инструментов), 0.3 = сбалансированный по умолчанию, 1.0 = только семантический (лучше всего для концептуальных запросов или запросов на естественном языке). min_score: Минимальная нормализованная оценка релевантности (0.0–1.0) для включения результата. Результаты с оценкой ниже этого порога отбрасываются. По умолчанию 0.0 возвращает все результаты. Используйте 0.2–0.4, чтобы убрать низкорелевантный шум. snippet_mode: Если true (по умолчанию), обрезает содержимое до ~500 символов на естественном разрыве и добавляет поле content_length с исходным размером. Используйте get_document(), чтобы получить полное содержимое при необходимости. Установите false, чтобы вернуть полное содержимое фрагмента. search_method: Селектор диспетчеризации (v4.8.2+). Одно из "auto" (роутер выбирает быстрый путь FTS5 для лексических запросов, если включено, иначе гибридный), "hybrid" (принудительно гибридный путь — аварийный выключатель при подозрении на неверную классификацию роутера) или "fts5" (принудительно быстрый путь FTS5 — отладка/тестирование; вызывает ошибку, если функция отключена или индекс не готов). По умолчанию "auto" сохраняет поведение до v4.8.2 побайтово, если быстрый путь отключён в конфигурации. Возвращает: Строку JSON с результатами, включая фрагменты содержимого, путь к исходному файлу, оценку релевантности и использованный метод поиска. Возвращает фрагменты, а не полное содержимое документа. Использование: Основной инструмент поиска — используйте для любого поиска по теме или ключевым словам. Предпочитайте search_similar(), если у вас уже есть…

Параметры
  • categorystring
  • hybrid_alphanumber
  • max_resultsinteger
  • min_scorenumber
  • querystringобязательный
  • search_methodstring
  • snippet_modeboolean
search_similar

Находит документы, семантически похожие на заданный эталонный документ. Только чтение. Без побочных эффектов. Использует эмбеддинг документа для сравнения сходства. Аргументы: filepath: Путь к эталонному документу (должен быть проиндексирован - используйте list_documents() для проверки). Например, "security/technique.md" max_results: Количество возвращаемых похожих документов (по умолчанию: 5, максимум: 20) Возвращает: Строку JSON со списком путей к похожим документам и оценками сходства (0.0-1.0). Применение: Используйте, когда у вас есть конкретный документ и вы хотите найти тематически связанные с ним. Вместо этого используйте search_knowledge(), когда у вас текстовый запрос, а не эталонный документ. Эталонный документ должен быть проиндексирован - вызовите list_documents(), чтобы убедиться, что он существует, перед вызовом этого инструмента.

Параметры
  • filepathstringобязательный
  • max_resultsinteger
update_document

Обновляет содержимое существующего документа в базе знаний. Мутирующая операция: перезаписывает файл на диске и сразу переиндексирует. Старые фрагменты удаляются и заменяются новыми. Полная замена содержимого, а не исправление. Args: filepath: Полный или относительный путь к файлу документа. Должен быть уже проиндексированным файлом: используйте list_documents() для поиска доступных путей. content: Новое полное текстовое содержимое, которое полностью заменяет существующее содержимое Returns: Строка JSON с результатами обновления (количество старых фрагментов, количество новых фрагментов, статус). Usage: Используется для полной замены содержимого документа. Используйте add_document() для создания нового файла вместо этого. Используйте remove_document() для удаления без замены. Изменения сразу становятся доступными для поиска: ручная переиндексация не требуется.

Параметры
  • contentstringобязательный
  • filepathstringобязательный
4.11.0основная
4.9.0
4.8.5
4.8.4
4.8.3
4.8.1
4.8.0
4.7.1
4.7.0
4.6.0
4.5.1
4.5.0
4.4.0
4.3.1
4.3.0
4.2.0
3.9.0
3.8.1
3.8.0
3.7.0
3.6.2
3.6.1
3.6.0

Выберите клиент, чтобы установить lyonzin/knowledge-rag:

Любой клиент

Конфиг добавления MCP сервера стандартный, обычно он не меняется вообще, поэтому подходит практически к любому ИИ клиенту, поддерживающему MCP.

{
  "mcpServers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}
CursorCursor

Перейдите по ссылке и сервер автоматически будет добавлен в Cursor. Либо откройте/создайте файл ~/.cursor/mcp.json(%USERPROFILE%\.cursor\mcp.json на Windows) и добавьте конфиг сервера:

{
  "mcpServers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}
VS Code

Создайте .vscode/mcp.json в проекте (ключ верхнего уровня — servers):

{
  "servers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "type": "stdio",
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}

Либо добавьте сервер через терминал:

code --add-mcp "{\"name\":\"lyonzin-knowledge-rag-qufpda3swv\",\"type\":\"stdio\",\"command\":\"npx\",\"args\":[\"-y\",\"knowledge-rag\"]}"
ClaudeClaude Desktop

Откройте Settings → Developer → Edit Config — это откроет файл claude_desktop_config.json:

  • macOS: ~/Library/Application Support/Claude/claude_desktop_config.json
  • Windows: %APPDATA%\Claude\claude_desktop_config.json

Впишите сервер и полностью перезапустите Claude Desktop:

{
  "mcpServers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}
Claude CodeClaude Code

Добавьте сервер одной командой в терминале:

claude mcp add lyonzin-knowledge-rag-qufpda3swv -- npx -y knowledge-rag

Либо через JSON-конфиг:

claude mcp add-json lyonzin-knowledge-rag-qufpda3swv "{\"command\":\"npx\",\"args\":[\"-y\",\"knowledge-rag\"]}"
CodexCodex

Добавьте сервер командой в терминале:

codex mcp add lyonzin-knowledge-rag-qufpda3swv -- npx -y knowledge-rag

Либо вручную в ~/.codex/config.toml(%USERPROFILE%\.codex\config.toml на Windows):

[mcp_servers.lyonzin-knowledge-rag-qufpda3swv]
command = "npx"
args = ["-y", "knowledge-rag"]
PerplexityPerplexity

MCP доступен подписчикам Perplexity Pro / Max / Enterprise. Локальные серверы — только в приложении для macOS.

  1. Откройте Настройки аккаунта → Connectors.
  2. Установите вспомогательное приложение PerplexityXPC (один раз).
  3. Нажмите Add Connector → вкладка Simple.
  4. В поле Server Name укажите lyonzin/knowledge-rag, а в поле команды запуска — строку ниже:
npx -y knowledge-rag

Нажмите Save и дождитесь статуса Running.

WindsurfWindsurf

Откройте Windsurf Settings → Cascade → MCP Servers или отредактируйте файл ~/.codeium/windsurf/mcp_config.json:

{
  "mcpServers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}
ClineCline

В панели Cline нажмите иконку MCP Servers → Configure → Configure MCP Servers (или отредактируйте ~/.cline/mcp.json) и добавьте сервер:

{
  "mcpServers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ],
      "disabled": false,
      "autoApprove": []
    }
  }
}
Continue

Создайте файл в .continue/mcpServers/ (например lyonzin-knowledge-rag-qufpda3swv.yaml) или добавьте блок в config.yaml. MCP работает только в режиме agent:

mcpServers:
  - name: lyonzin-knowledge-rag-qufpda3swv
    command: npx
    args:
      - "-y"
      - "knowledge-rag"
Zed

Выполните agent: add context server или откройте настройки (zed: open settings file) и добавьте сервер в объект context_servers:

{
  "context_servers": {
    "lyonzin-knowledge-rag-qufpda3swv": {
      "command": "npx",
      "args": [
        "-y",
        "knowledge-rag"
      ]
    }
  }
}

Похожие MCP-сервера

shinpr/mcp-local-rag

shinpr/mcp-local-rag

от shinpr

MCP сервер для локального семантического поиска с бустом ключевых слов (например, коды ошибок, имена функций). Индексирует PDF, DOCX, TXT, MD без облака, работает offline. Удобен разработчикам: быстрый доступ к технической документации и коду через MCP или CLI. Запуск одной командой npx без Docke...

TypeScript⭐ 415
ndjordjevic/pinrag

ndjordjevic/pinrag

от ndjordjevic

PinRAG индексирует PDF, GitHub, YouTube, Discord и заметки в единый RAG-индекс. Задавайте вопросы из редактора — ответы с цитатами на источники. Полезен разработчикам и исследователям для работы с ...

Python⭐ 2
dmayboroda/minima

dmayboroda/minima

от dmayboroda

Minima — open-source MCP сервер для локального RAG в контейнерах. Поддерживает изолированный Ollama, кастомные LLM и интеграцию с ChatGPT и Claude. Индексирует документы и отвечает на вопросы, обеспечивая полный контроль над данными. Полезен для конфиденциальных проектов и офлайн-сред.

Python⭐ 1054
needle-ai/needle-mcp

needle-ai/needle-mcp

от needle-ai

MCP сервер для интеграции с Needle — управляйте документами, ищите по коллекциям через Claude Desktop. Поддерживает PDF, DOCX и другие форматы, делая данные доступными для семантического поиска без локальной установки. Идеально для AI-агентов.

Python⭐ 104
vezlo/src-to-kb

vezlo/src-to-kb

от vezlo

Преобразует любой репозиторий исходного кода в поисковую базу знаний с автоматической разбивкой, эмбеддингами и интеллектуальным поиском. Поддерживает MCP для интеграции с Claude Code и Cursor, пол...

JavaScript⭐ 40
vectara/vectara-mcp

vectara/vectara-mcp

официальный

от vectara

MCP-сервер для RAG с Vectara: семантический поиск, генерация и коррекция галлюцинаций. Помогает AI-агентам выдавать фактологически точные ответы с верификацией. Совместим с Claude Desktop.

Python⭐ 29
© Каталог MCP, 2026. Все права защищены.
Проект не аффилирован с Anthropic и любыми упомянутыми продуктами.
Все названия и торговые марки принадлежат их владельцам.
Контакты для связи: hi@mcp-katalog.ru

Лука Никитин