scrapeless-ai/scrapeless-mcp-server

scrapeless-ai/scrapeless-mcp-server

от scrapeless-ai
Scrapeless MCP Server подключает LLM и AI-агентов к вебу: поиск Google, тренды, браузерная автоматизация, скрапинг (HTML, Markdown, скриншоты). Применяется для AI-ассистентов, копилотов и веб-агентов.

preview

Scrapeless MCP Server

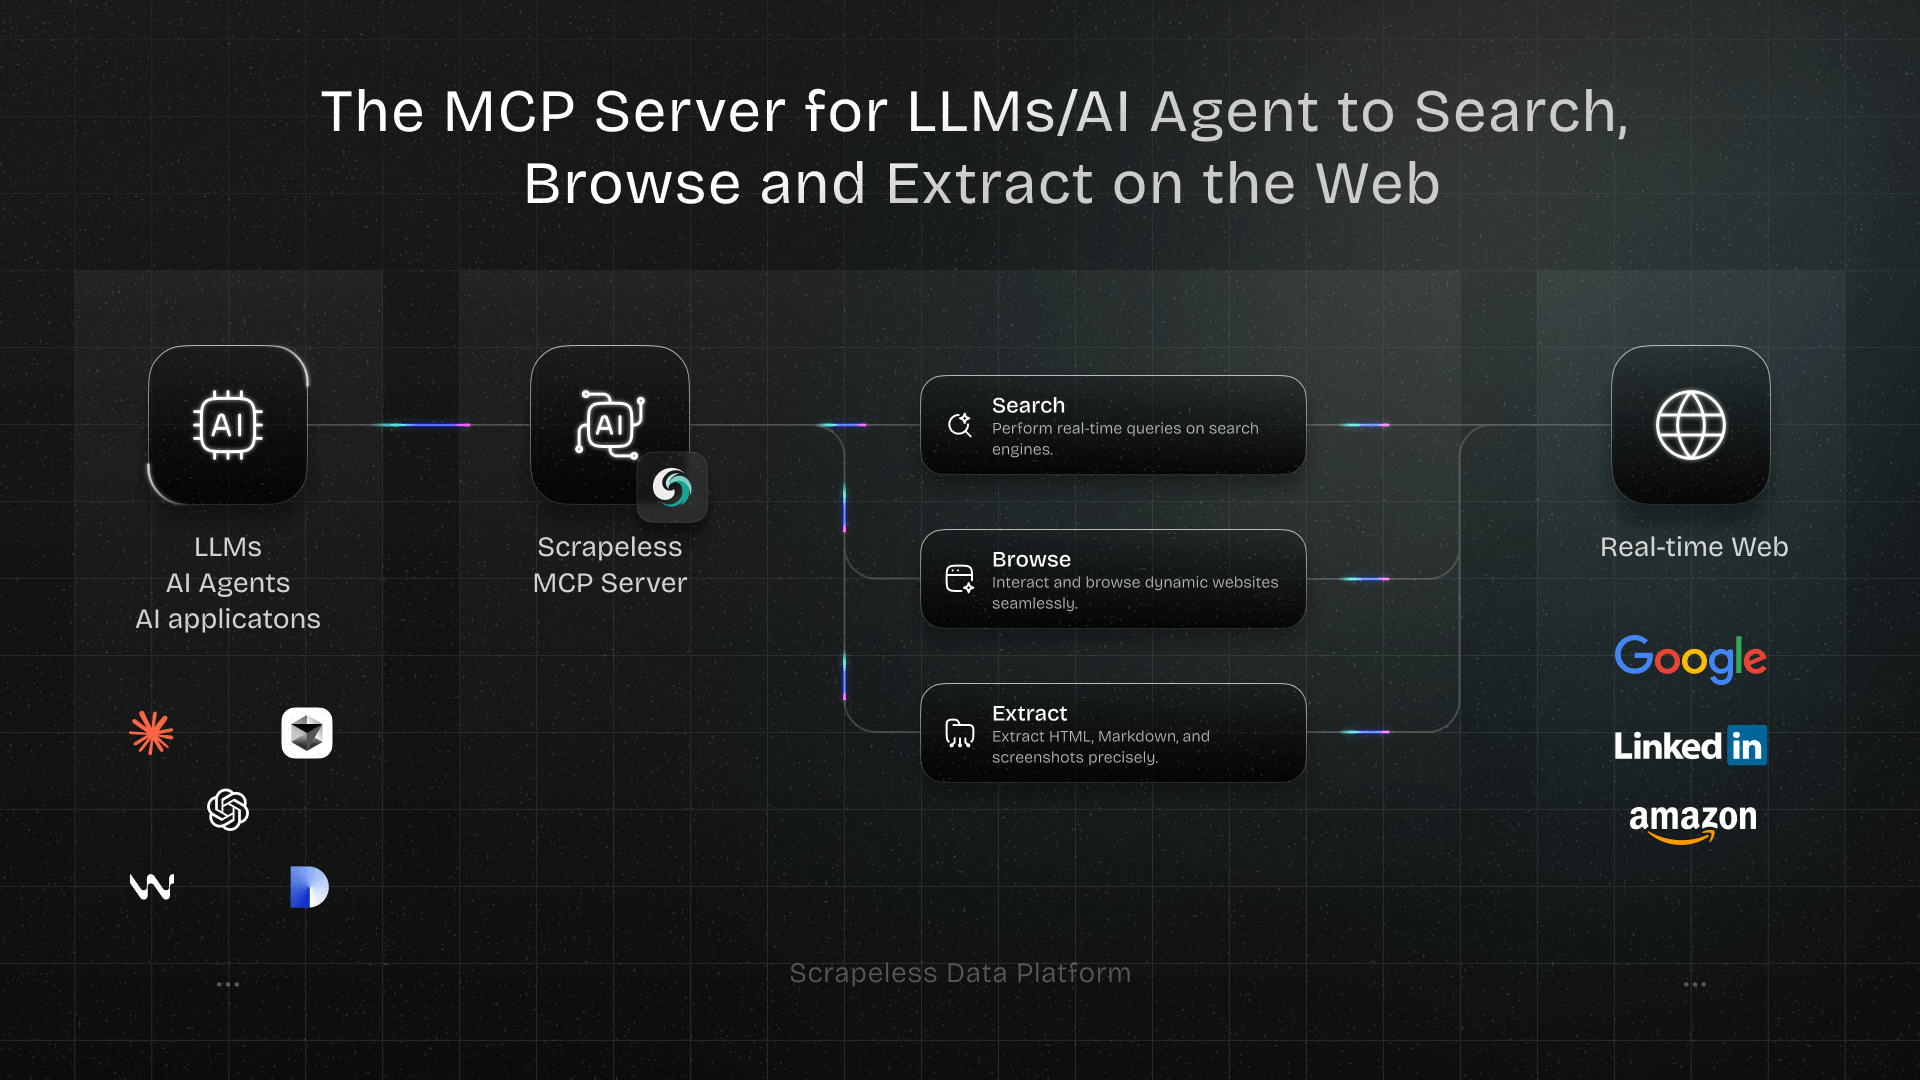
Welcome to the official Scrapeless Model Context Protocol (MCP) Server — a powerful integration layer that empowers LLMs, AI Agents, and AI applications to interact with the web in real time.

Built on the open MCP standard, Scrapeless MCP Server seamlessly connects models like ChatGPT, Claude, and tools like Cursor and Windsurf to a wide range of external capabilities, including:

  • Google services integration (Search, Trends)
  • Browser automation for page-level navigation and interaction
  • Scrape dynamic, JS-heavy sites—export as HTML, Markdown, or screenshots
  • Crawl entire websites by following links and capture each page in multiple formats
  • AI Scraper Create an AI Scraper task for ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok, or Alexa

Whether you're building an AI research assistant, a coding copilot, or autonomous web agents, this server provides the dynamic context and real-world data your workflows need—without getting blocked.

Usage Examples

Часто задаваемые вопросы

Инструменты были проиндексированы:
ai_scraper

Создаёт задачу AI Scraper для явно указанного актора Scrapeless, затем опрашивает каждые 5 секунд, пока ответ не будет готов или не истечёт тайм-аут. Поддерживает ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok и Alexa. По умолчанию тайм-аут составляет 3 минуты. Тайм-аут можно установить от 60 до 600 секунд. При истечении тайм-аута возвращает task_id и инструкции для ручного получения результата.

Параметры
  • actorenumобязательный

    Актор Scrapeless для запуска. Выберите один явно: scraper.chatgpt, scraper.gemini, scraper.perplexity, scraper.copilot, scraper.aimode, scraper.overview, scraper.grok или scraper.alexa.

  • countrystring

    Код страны или региона, используемый актором. По умолчанию - US.

  • locationstring

    Каноническое местоположение Google для Google AI Mode или Google AI Overview. Взаимоисключается с uule.

  • modeenum

    Требуется для scraper.copilot или scraper.grok. Copilot: search, smart, chat, reasoning, study. Grok: MODEL_MODE_FAST, MODEL_MODE_EXPERT, MODEL_MODE_AUTO.

  • promptstringобязательный

    Вопрос или запрос для отправки выбранному AI Scraper actor.

  • shoppingboolean

    Получает данные о покупках/товарах для scraper.chatgpt, scraper.aimode или scraper.overview, когда они явно указаны.

  • timeout_secondsinteger

    Максимальное время опроса в секундах. По умолчанию 180. Минимальное значение 60, максимальное 600.

  • uulestring

    Предварительно закодированный Google UULE для Google AI Mode или Google AI Overview. Взаимоисключается с location.

  • webhookobject

    Необязательный объект webhook, передаваемый в запрос задачи Scrapeless.

  • web_searchboolean

    Включает веб-поиск для scraper.chatgpt или scraper.perplexity, когда они явно указаны.

browser_click

Нажми на конкретный элемент на странице. Ограничения: требуется валидный CSS-селектор для целевого элемента. Правильно: нажать на кнопку с селектором "#submit-button". Неправильно: нажать "кнопка входа" без указания селектора.

Параметры
  • selectorstringобязательный

    CSS-селектор элемента для клика.

  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_close

Закрывает текущую сессию, отключая облачный браузер. Это завершит запись для сессии.

Параметры
  • sessionIdstringобязательный

    Идентификатор сессии для определения целевого браузера. Если он не указан или недействителен, закрыть сессию невозможно.

browser_create

Создаёт или переиспользует сессию облачного браузера с помощью Scrapeless. Обновляет активную сессию.

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования или переиспользования. Если не указан или недействителен, создается новый сеанс.

browser_get_html

Получает полный HTML текущей страницы. Ограничения: возвращает весь исходный HTML-код. Верно: получить HTML текущей страницы, чтобы разобрать её структуру. Неверно: получить только видимый текст (используйте "browser_get_text")

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_get_text

Получить весь видимый текст с текущей страницы. Ограничения: Извлекает только текстовое содержимое, игнорируя HTML-теги. Допустимо: Получить текстовое содержимое текущей страницы для реферирования. Недопустимо: Получить HTML-структуру страницы (используйте "browser_get_html")

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_go_back

Вернуться на один шаг назад в истории браузера. Ограничения: Работает только если в истории сеанса есть предыдущая страница. Допустимо: После перехода со страницы А на страницу В вернуться обратно на А. Недопустимо: Попытка вернуться назад на первой странице сеанса.

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_go_forward

Перейти на один шаг вперед в истории браузера. Ограничения: Работает только после выполнения действия "go_back". Допустимо: После возврата со страницы B на страницу A перейти вперед на страницу B. Недопустимо: Попытка перехода вперед без предшествующего действия "go_back".

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_goto

Перейти в браузере по указанному URL. Ограничения: только для прямого перехода по URL, не для поиска. Верно: перейти на https://google.com. Неверно: искать «cats» в Google (используйте google_search).

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

  • urlstringобязательный

    URL-адрес для перехода в сессии браузера.

browser_press_key

Симулировать нажатие клавиши. Ограничения: необходимо указать допустимое имя клавиши; селектор цели необязателен. Допустимо: Нажать Enter в #search. Недопустимо: Нажать клавишу без указания имени клавиши.

Параметры
  • keystringобязательный

    Название клавиши для нажатия или символ для генерации, например, ArrowLeft или a.

  • selectorstring

    CSS-селектор элемента, который нужно сфокусировать.

browser_screenshot

Сделать скриншот текущей страницы. Ограничения: можно сделать скриншот всей страницы или видимой области. Допустимо: сделать скриншот текущего вида браузера. Недопустимо: сделать скриншот конкретного элемента (не поддерживается).

Параметры
  • fullPageboolean

    Нужно ли делать скриншот всей страницы (по умолчанию: false) Избегайте полноэкранных снимков, если это не важно, так как изображения могут быть довольно большими.

  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_scroll

Прокручивает текущую страницу до определённой позиции. Ограничения: Для прокрутки требуются координаты в пикселях. Допустимо: Прокрутка до низа страницы (например, { x: 0, y: 10000 }). Недопустимо: Прокрутка «вверх» без указания координат.

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_scroll_to

Прокрутить конкретный элемент в область видимости. Ограничения: требуется валидный CSS-селектор для целевого элемента. Допустимо: Прокрутка к элементу "#footer". Недопустимо: Прокрутка вниз страницы (используйте "browser_scroll").

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

  • xnumberобязательный

    Координата X для прокрутки.

  • ynumberобязательный

    Координата Y для прокрутки.

browser_snapshot

Захватывает полную структуру веб-страницы, включая DOM и ресурсы, для инспекции и анализа.

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

browser_type

Вводит текст в указанное поле ввода. Ограничения: требуется CSS-селектор для input/textarea и текст для ввода. Верно: Ввести "hello world" в input "[name='q']". Неверно: Ввести "hello world" без указания целевого поля.

Параметры
  • selectorstringобязательный

    CSS-селектор для элемента, в который нужно вводить текст.

  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

  • textstringобязательный

    Текст для ввода.

browser_wait

Приостанавливает выполнение на заданное время. Ограничения: Требуется указать длительность в миллисекундах. Следует использовать редко. Допустимо: Подождать 2000 миллисекунд. Недопустимо: Ждать загрузки страницы (используйте "browser_wait_for")

Параметры
  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

  • timeintegerобязательный

    Время ожидания в миллисекундах (по умолчанию: 30000).

browser_wait_for

Дождаться появления определённого элемента на странице. Ограничения: Требуется валидный CSS-селектор для ожидаемого элемента. Правильно: Дождаться, когда элемент «#results» станет видимым. Неправильно: Ждать «загрузки результатов» без селектора.

Параметры
  • selectorstringобязательный

    CSS-селектор элемента, которого нужно ожидать.

  • sessionIdstring

    Необязательный идентификатор сеанса для использования/переиспользования. Если не указан или недействителен, используется активный сеанс.

  • timeoutnumber

    Максимальное время ожидания в миллисекундах (по умолчанию: 30000).

crawl_cancel

Отменяет выполняющуюся задачу обхода по её идентификатору (идентификатору, возвращённому crawl_start). Возвращает статус отмены.

Параметры
  • idstringобязательный

    Идентификатор задания обхода, возвращаемый при создании задания.

crawl_result

Получает результат задания краулинга по его идентификатору (идентификатор возвращается функцией crawl_start). Опрашивает статус задания, пока он не достигнет конечного состояния (completed / failed / cancelled) или не истечет тайм-аут. Если тайм-аут истекает до завершения задания, возвращается последний статус вместе с идентификатором задания, чтобы вы могли повторить попытку позже.

Параметры
  • idstringобязательный

    Идентификатор задания обхода, возвращаемый при создании задания.

  • pollIntervalnumber

    Интервал между проверками статуса в секундах. По умолчанию - 5 секунд.

  • timeoutnumber

    Максимальное время ожидания в секундах перед возвратом последнего результата. По умолчанию 300 (5 минут).

crawl_start

Запускает асинхронную задачу обхода. Обходит сайт, начиная с базового URL, переходя по ссылкам в соответствии с указанными параметрами, и сохраняет содержимое страниц в различных форматах (markdown, html, links, screenshot и т. д.). Возвращает идентификатор задачи, который можно использовать с crawl_result для получения результатов и с crawl_cancel для отмены задачи. Требуется только 'url'; все остальные параметры необязательны.

Параметры
  • allowBackwardLinksboolean

    Разрешает краулеру переходить по ссылкам, которые не входят в указанную вами иерархию URL.

  • allowExternalLinksboolean

    Разрешает краулеру переходить по ссылкам на внешние сайты.

  • browserOptionsobject

    Параметры, управляющие базовой сессией браузера для скрейпинга.

  • deduplicateSimilarURLsboolean

    Определяет, нужно ли дедуплицировать похожие URL.

  • delaynumber

    Задержка в секундах между скрейпами. Это помогает соблюдать ограничения частоты запросов к сайту.

  • excludePathsstring[]

    Регулярные выражения для URL pathname, которые исключают совпадающие URL из обхода.

  • ignoreQueryParametersboolean

    Не пересканируйте один и тот же путь с разными параметрами запроса или без них.

  • ignoreSitemapboolean

    Игнорируйте карту сайта при обходе.

  • includePathsstring[]

    Regex-шаблоны путей URL, включающие совпадающие URL в данных обхода.

  • limitnumber

    Максимальное количество страниц для обхода. Ограничение по умолчанию - 10000.

  • maxDepthnumber

    Максимальная глубина обхода относительно базового URL (максимальное количество слэшей в пути).

  • maxDiscoveryDepthnumber

    Максимальная глубина обхода в зависимости от порядка обнаружения.

  • regexOnFullURLboolean

    Определяет, следует ли применять регулярное выражение include/exclude к полному URL.

  • scrapeOptionsobject

    Параметры, управляющие тем, как извлекается каждая страница.

  • urlstringобязательный

    Базовый URL, с которого начинается обход.

google_search

Universal Information Search Engine. Извлекает любую информацию; пояснительные запросы (почему, как); запросы сравнительного анализа.

Параметры
  • glstring

    Параметр определяет страну для поиска Google. Это двухбуквенный код страны. (например, us для Соединённых Штатов, uk для Соединённого Королевства или fr для Франции).

  • hlstring

    Параметр определяет язык для поиска Google. Это двухбуквенный код языка (например, en для английского, es для испанского или fr для французского).

  • qstring

    Параметр задаёт поисковый запрос. Можно использовать всё, что работает в обычном поиске Google, например: inurl:, site:, intitle:. Также поддерживаются расширенные параметры запроса, такие как as_dt и as_eq.

google_trends

Получает данные о популярных поисковых запросах из Google Trends. Ограничения: Активен для запросов о трендах, популярности или изменении интереса во времени. Допустимо: Найти интерес к поиску «ИИ» за последний год. Недопустимо: Общий вопрос вроде «Что такое ИИ?» (используйте google_search).

Параметры
  • catstring

    Параметр определяет категорию поиска. Значение по умолчанию установлено на 0 («Все категории»).

  • data_typestring

    Поддерживаемые типы: autocomplete, interest_over_time, compared_breakdown_by_region, interest_by_subregion, related_queries, related_topics.

  • datestring

    Поддерживаемые даты: сейчас 1-Ч, сейчас 4-Ч, сейчас 1-д, сейчас 7-д, сегодня 1-м, сегодня 3-м, сегодня 12-м, сегодня 5-л, все. Вы также можете передать пользовательские значения: Даты с 2004 года по настоящее время: гггг-мм-дд гггг-мм-дд (например, 2021-10-15 2022-05-25) Даты с часами в пределах недели: гггг-мм-ддTчч гггг-мм-ддTчч (например, 2022-05-19T10 2022-05-24T22). Часы будут рассчитаны в зависимости от параметра tz (часовой пояс).

  • geoenum

    Параметр определяет местоположение, из которого должен начинаться поиск. По умолчанию установлено значение Worldwide (активируется, когда значение параметра geo не задано или пусто).

  • hlstring

    Определяет язык для поиска в Google Trends. Это двухбуквенный код языка (например, en для английского, es для испанского или fr для французского).

  • qstring

    Параметр определяет запрос или запросы, которые вы хотите искать. Вы можете использовать всё, что вы бы использовали в обычном поиске Google Trends. Максимальное количество запросов на поиск составляет 5 (это относится только к типам данных interest_over_time и compared_breakdown_by_region, другие типы данных принимают только 1 запрос на поиск).

  • tzstring

    Смещение часового пояса. Значение по умолчанию: 420.

scrape_html

Извлекает содержимое URL и возвращает полный HTML. Ограничения: Включён для URL, требующих рендеринга JavaScript или защиты от ботов. Допустимо: получать HTML из динамического одностраничного приложения с большим количеством JS. Недопустимо: запрашивать простую статическую страницу (используйте стандартный HTTP-клиент).

Параметры
  • urlstringобязательный

    Целевой URL

scrape_markdown

Извлекает содержимое URL и возвращает его в формате Markdown. Ограничения: лучше всего подходит для статей, записей в блогах и других страниц с большим объёмом текста. Допустимо: извлечь новостную статью, чтобы получить её читаемый контент. Недопустимо: извлекать содержимое сложной панели управления веб-приложения.

Параметры
  • urlstringобязательный

    Целевой URL

scrape_screenshot

Сделать скриншот любой веб-страницы в высоком качестве. Ограничения: обходит обнаружение ботов и CAPTCHA с помощью резидентных прокси. Допустимо: получить скриншот страницы проверки цен, защищённой Cloudflare. Недопустимо: создание скриншота локального браузера (используйте browser_screenshot)

Параметры
  • urlstringобязательный

    Целевой URL

0.6.3основная
0.6.1
0.6.0
0.5.0
0.4.9
0.4.8
0.4.7
0.4.6
0.4.5
0.4.4
0.4.3
0.4.2
0.4.1
0.4.0
0.3.0
0.1.4
0.1.3
0.1.2
0.1.1
0.1.0

Выберите клиент, чтобы установить scrapeless-ai/scrapeless-mcp-server:

Любой клиент

Конфиг добавления MCP сервера стандартный, обычно он не меняется вообще, поэтому подходит практически к любому ИИ клиенту, поддерживающему MCP.

{
  "mcpServers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
CursorCursor

Перейдите по ссылке и сервер автоматически будет добавлен в Cursor. Либо откройте/создайте файл ~/.cursor/mcp.json(%USERPROFILE%\.cursor\mcp.json на Windows) и добавьте конфиг сервера:

{
  "mcpServers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
VS Code

Создайте .vscode/mcp.json в проекте (ключ верхнего уровня — servers):

{
  "servers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "type": "stdio",
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}

Либо добавьте сервер через терминал:

code --add-mcp "{\"name\":\"scrapeless-ai-scrapeless-mcp-server-rdo21g8v93\",\"type\":\"stdio\",\"command\":\"npx\",\"args\":[\"-y\",\"scrapeless-mcp-server\"],\"env\":{\"SCRAPELESS_KEY\":\"YOUR_SCRAPELESS_KEY\"}}"
ClaudeClaude Desktop

Откройте Settings → Developer → Edit Config — это откроет файл claude_desktop_config.json:

  • macOS: ~/Library/Application Support/Claude/claude_desktop_config.json
  • Windows: %APPDATA%\Claude\claude_desktop_config.json

Впишите сервер и полностью перезапустите Claude Desktop:

{
  "mcpServers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
Claude CodeClaude Code

Добавьте сервер одной командой в терминале:

claude mcp add scrapeless-ai-scrapeless-mcp-server-rdo21g8v93 --env SCRAPELESS_KEY=YOUR_SCRAPELESS_KEY -- npx -y scrapeless-mcp-server

Либо через JSON-конфиг:

claude mcp add-json scrapeless-ai-scrapeless-mcp-server-rdo21g8v93 "{\"command\":\"npx\",\"args\":[\"-y\",\"scrapeless-mcp-server\"],\"env\":{\"SCRAPELESS_KEY\":\"YOUR_SCRAPELESS_KEY\"}}"
CodexCodex

Добавьте сервер командой в терминале:

codex mcp add scrapeless-ai-scrapeless-mcp-server-rdo21g8v93 --env SCRAPELESS_KEY=YOUR_SCRAPELESS_KEY -- npx -y scrapeless-mcp-server

Либо вручную в ~/.codex/config.toml(%USERPROFILE%\.codex\config.toml на Windows):

[mcp_servers.scrapeless-ai-scrapeless-mcp-server-rdo21g8v93]
command = "npx"
args = ["-y", "scrapeless-mcp-server"]

[mcp_servers.scrapeless-ai-scrapeless-mcp-server-rdo21g8v93.env]
SCRAPELESS_KEY = "YOUR_SCRAPELESS_KEY"
PerplexityPerplexity

MCP доступен подписчикам Perplexity Pro / Max / Enterprise. Локальные серверы — только в приложении для macOS.

  1. Откройте Настройки аккаунта → Connectors.
  2. Установите вспомогательное приложение PerplexityXPC (один раз).
  3. Нажмите Add Connector → вкладка Simple.
  4. В поле Server Name укажите scrapeless-ai/scrapeless-mcp-server, а в поле команды запуска — строку ниже:
npx -y scrapeless-mcp-server

Нажмите Save и дождитесь статуса Running.

WindsurfWindsurf

Откройте Windsurf Settings → Cascade → MCP Servers или отредактируйте файл ~/.codeium/windsurf/mcp_config.json:

{
  "mcpServers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
ClineCline

В панели Cline нажмите иконку MCP Servers → Configure → Configure MCP Servers (или отредактируйте ~/.cline/mcp.json) и добавьте сервер:

{
  "mcpServers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "autoApprove": []
    }
  }
}
Continue

Создайте файл в .continue/mcpServers/ (например scrapeless-ai-scrapeless-mcp-server-rdo21g8v93.yaml) или добавьте блок в config.yaml. MCP работает только в режиме agent:

mcpServers:
  - name: scrapeless-ai-scrapeless-mcp-server-rdo21g8v93
    command: npx
    args:
      - "-y"
      - "scrapeless-mcp-server"
    env:
      SCRAPELESS_KEY: YOUR_SCRAPELESS_KEY
Zed

Выполните agent: add context server или откройте настройки (zed: open settings file) и добавьте сервер в объект context_servers:

{
  "context_servers": {
    "scrapeless-ai-scrapeless-mcp-server-rdo21g8v93": {
      "command": "npx",
      "args": [
        "-y",
        "scrapeless-mcp-server"
      ],
      "env": {
        "SCRAPELESS_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}

Похожие MCP-сервера

hyperbrowserai/mcp

hyperbrowserai/mcp

от hyperbrowserai

MCP сервер Hyperbrowser для скрапинга, краулинга и извлечения структурированных данных. Включает браузерные агенты OpenAI CUA и Claude. Для веб-автоматизации и сбора данных LLM.

TypeScript⭐ 789
Custodia-Admin/pagebolt-mcp

Custodia-Admin/pagebolt-mcp

от custodia-admin

PageBolt MCP сервер открывает AI-ассистентам браузерную веб-автоматизацию: скриншоты, PDF и запись демо-видео. Также инспектирует страницы и создаёт OG-картинки. Просто опишите задачу — сервер выполнит.

JavaScript⭐ 4
aparajithn/agent-scraper-mcp

aparajithn/agent-scraper-mcp

от aparajithn

MCP инструмент для веб-скрапинга: извлекает чистый контент в markdown, делает скриншоты, собирает метаданные и ссылки с сайтов, а также ищет в Google. Разработчики AI-агентов используют его для автоматизации сбора данных с веб-страниц. Доступен через REST API с бесплатным лимитом 50 запросов в день.

Python⭐ 8
ymw0407/auth-fetch-mcp

ymw0407/auth-fetch-mcp

от ymw0407

MCP сервер для AI-ассистентов: открывает браузер для входа на защищённые страницы, захватывает очищенный HTML и сохраняет сессии локально. Помогает разработчикам читать сайты с авторизацией через ИИ без повторных логинов.

TypeScript⭐ 36
junipr-labs/mcp-server

junipr-labs/mcp-server

от junipr-labs

MCP-сервер Junipr даёт AI-ассистентам доступ к 75+ инструментам веб-интеллигенции: скриншоты, PDF, метаданные и многое другое. Бесплатный тариф: 500 кредитов/месяц. Всё через один API.

JavaScript⭐ 1
kimtth/mcp-aoai-web-browsing

kimtth/mcp-aoai-web-browsing

от kimtth

Сервер MCP для браузерной автоматизации через Playwright, интегрированный с Azure OpenAI и OpenAI. Преобразует инструменты MCP в вызовы функций OpenAI, позволяя AI-агентам управлять веб-страницами....

Python⭐ 35
© Каталог MCP, 2026. Все права защищены.
Проект не аффилирован с Anthropic и любыми упомянутыми продуктами.
Все названия и торговые марки принадлежат их владельцам.
Контакты для связи: hi@mcp-katalog.ru

Лука Никитин